智能体性能评估、测试方法、日志分析
时长:约 46 分钟
本节要点
- 为什么智能体必须建立「持续、量化」的评估机制,而不是像传统软件那样一次测完。
- 评估的维度全景:任务完成度、输出质量、工具使用准确性、效率与成本、安全与合规、用户体验。
- 测试金字塔在智能体场景下的落法:单元 / 集成 / 端到端。
- 主流自动化测试框架:LangSmith、PromptFlow、pytest。
- 调试三板斧:日志、分布式追踪、隔离复现,以及让 LLM 输出推理链(CoT)辅助定位。
一、智能体评估为何重要
与传统软件的确定性逻辑不同,LLM 智能体的输出具有随机性:相同输入可能产生不同结果。因此「一次测试、永久有效」的旧模式失效,必须建立持续、量化、动态的评估机制。
评估不只是在结果上打个分,更是迭代依据——通过客观指标量化提示词优化、模型更换、工具升级等动作的效果,形成「评估驱动」的闭环。
二、评估维度全景
一张图看清六个核心维度:
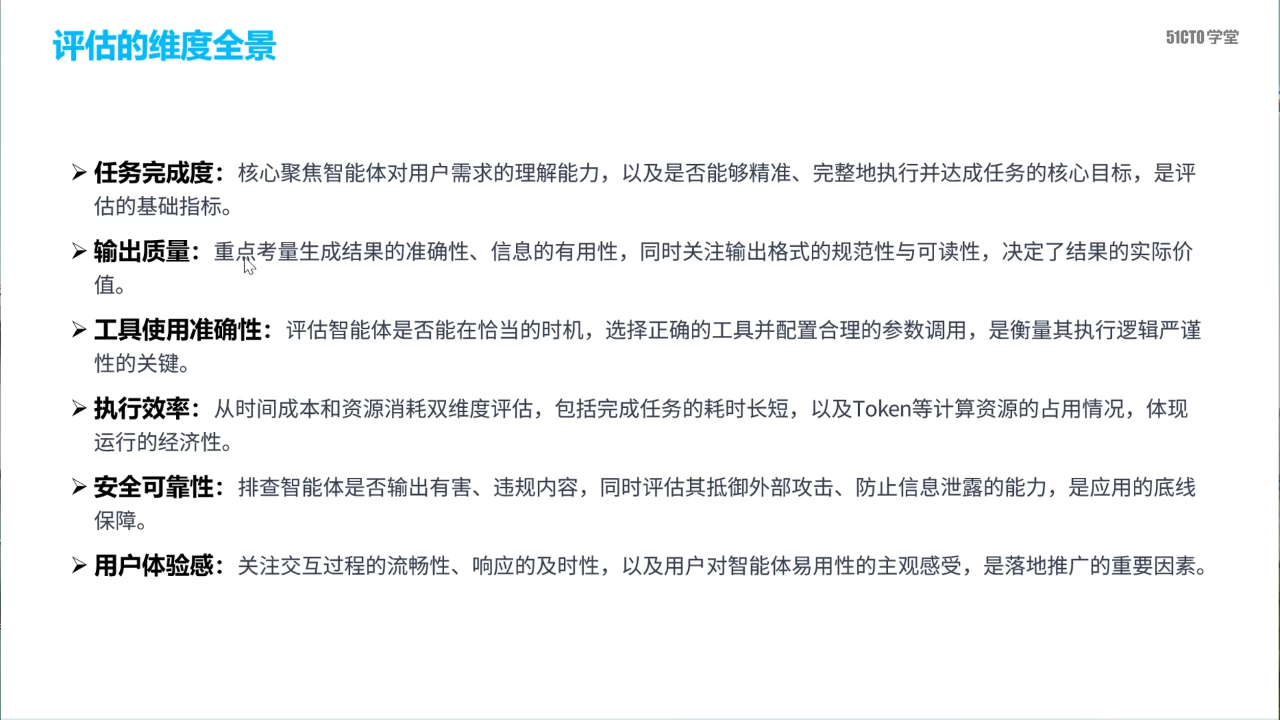
- 任务完成度:智能体是否精准、完整地理解并达成用户目标,是最基础的指标。
- 输出质量:结果的准确性、有用性,以及格式规范与可读性,决定结果的实际价值。
- 工具使用准确性:是否在恰当的时机选择正确的工具并配置合理参数,衡量执行逻辑的严谨度。
- 效率与成本:响应速度与资源消耗,直接影响用户体验和运营成本。
- 安全与合规:是否输出有害内容、是否泄露敏感信息。
- 用户体验:满意度与任务完成时间等主观感受指标。
三、任务完成度指标
- 任务成功率:成功完成任务的用例数 ÷ 总用例数 × 100%。关键在于先明确「成功完成」的判定标准,保证统计客观。
- 步骤完成率:多步工作流中成功执行到每一步的比例,主要用于诊断复杂任务的失败环节。例如大量任务卡在「调用支付 API」这一步,就能直接定位到该环节。
四、输出质量评估
- 人工评估(Human Evaluation):由专业人员依据预设评分标准(Rubric)打分,能评估流畅度、逻辑性、创造性等主观维度,是质量评估的「金标准」,但耗时、成本高、难规模化。
- 自动指标(Automated Metrics):
- 传统指标:BLEU、ROUGE 等,适合翻译、摘要类任务。
- LLM-as-Judge:如 G-Eval,用大模型按标准对输出打分,兼顾规模与质量。
五、工具使用准确性
- 工具选择准确率:在需要调用工具的场景中,智能体选择正确工具的比例。需构建标注好的测试集,明确每个 query 对应的预期工具作为基准。
- 参数提取准确率:调用工具时从用户输入中正确提取关键参数的比例。校验方式是比对生成参数的内容与格式是否与预期完全一致。
六、效率与成本
- 首 Token 时间(TTFT):从用户发送请求到智能体开始返回第一个字的时间,是交互流畅性的第一道门槛,TTFT 过长会让用户觉得「卡住了」。
- 端到端响应时间(End-to-End Latency):从发起到返回最终完整结果的总耗时,衡量完成整个任务的整体效率。
七、安全与合规指标
- 有害内容输出率:在对抗性测试(越狱、诱导性提问等)下,智能体输出歧视、暴力煽动、违法违规信息的占比,是模型价值观对齐的核心指标。
- 敏感信息泄露率:衡量智能体是否在输出中泄露用户隐私或内部敏感数据,需要专项测试集全量评估。
八、用户体验核心指标
- 用户满意度(CSAT):交互后的 1–5 星评分,取所有评分之和 ÷ 评分总次数,是最直观的体验指标。
- 任务完成时间:从启动交互到任务最终完成的总时长(含思考、等待、修正输入),直接体现易用性与服务效率。
九、构建评估集
- 真实场景用例收集:来自真实用户交互日志、用户反馈、客服工单,最能反映真实世界的使用与痛点,是评估集最有价值的基石。
- 合成数据生成:借助 LLM 生成多样化查询(例如「查询天气」可扩展出多语言、多表述的变体),快速覆盖不同场景、语言风格与表达习惯,尤其适合边缘场景和对抗性用例。
十、测试金字塔与智能体测试
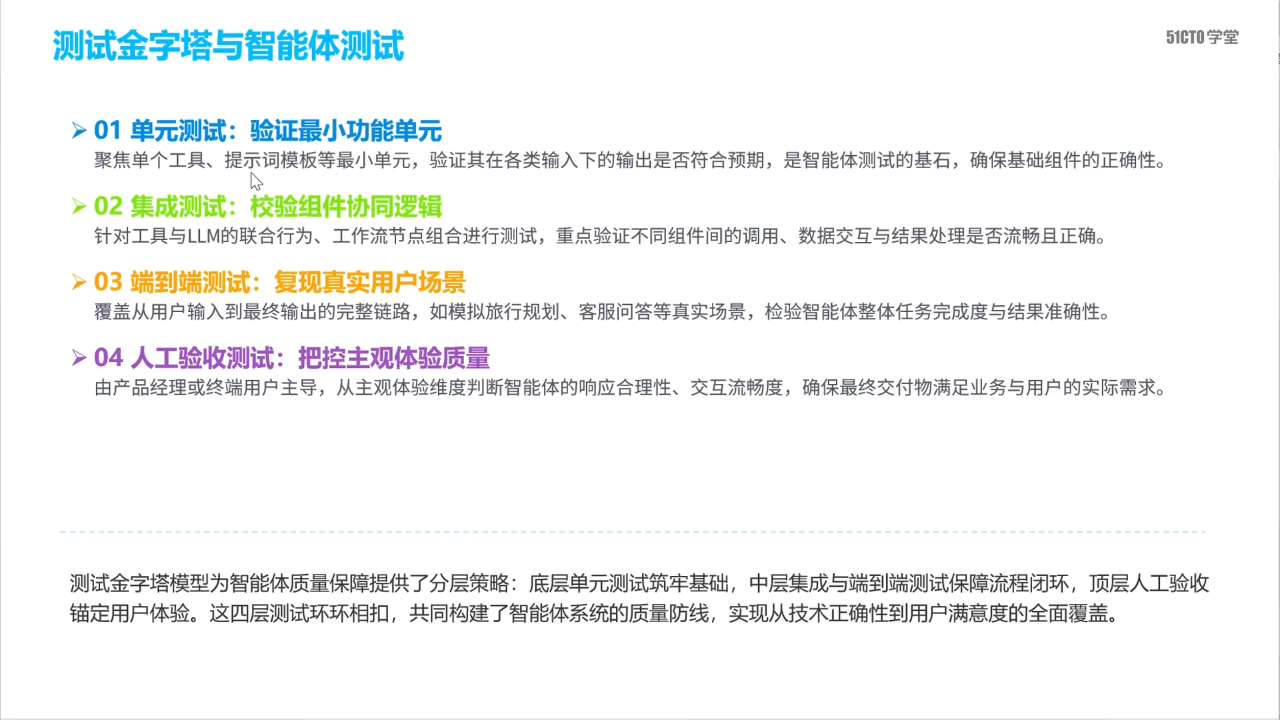
- 单元测试:验证最小功能单元(单个工具、单个提示逻辑),是测试基石。
- 集成测试:校验工具与 LLM 的联合行为、工作流节点组合,重点验证组件间的调用、数据交互与结果处理。
- 端到端测试:复现真实用户场景,走完整流程验证整体表现。
十一、单元测试:工具与提示
- 工具的独立测试:编写覆盖正常与异常场景的用例,传入边界值、非法参数,校验输出是否符合预期。例如计算器工具既验证「2+2」,也校验非法表达式是否能抛出或返回「计算错误」。
- 测试目标:保障每个「原子能力」的可靠性,让上层集成测试有稳定地基。
十二、用例设计方法
- 等价类划分:把输入划分为若干等价类,每类取代表数据。有效等价类(如年龄 0<年龄<120)与无效等价类(如 <0、>120、非数字),覆盖合法与非法场景。
- 边界值分析:大量错误发生在范围边界,因此聚焦边界值测试。
- 场景法:基于用户实际使用的端到端流程设计用例,先确定「主成功场景」,再发散「分支与异常场景」,覆盖中断、错误、变更等情况(典型例子如「订餐流程」)。
十三、设计智能体测试套件
- 标准化套件结构:每条用例包含唯一用例 ID、场景描述、用户输入、预期工具调用序列(工具名 + 参数)、预期最终输出,形成从输入到结果的完整链路定义,保证可复现、可追溯。
- 自动化断言规则:如
output_contains(输出包含指定关键词)、工具调用序列校验等,实现自动验证。
十四、自动化测试框架概览
- LangSmith:LangChain 官方平台,提供全链路调试、评测与监控能力。
- PromptFlow:微软出品,聚焦 AI 流程的可视化构建与多维度评估。
- 自研 + pytest:基于 Python 与 pytest 编写定制化自动化测试逻辑,灵活度最高。
十五、回归测试策略
- 明确触发时机:模型权重升级、提示词逻辑迭代、工具功能更新、工作流节点调整后,必须强制执行全量或增量回归测试。
- 建立基线快照:在稳定版本上跑完整套件,留存所有通过用例的标准输出作为「基线」,供后续对比。
- 自动化差异分析(Diff Analysis):对比新版本与基线输出,自动发现行为漂移,保障系统稳定性。
十六、人工评估与标注
- 双人标注 + 专家仲裁:两位标注员独立打分,分数差异超过阈值时引入第三位资深专家仲裁,规避单人主观偏差。
- 标准化评分细则(Rubric):制定 1–5 分全维度描述,例如 5 分=完全理解意图且输出准确优美,3 分=基本理解但存在少量格式/内容瑕疵,1 分=严重偏离,保证一致性。
十七、调试:当智能体出错了
常见错误类型:
- 选错工具(调用了无关能力)
- 幻觉参数(生成了未提及的参数)
- 死循环(思考—行动无限往复)
- 超时(推理或调用耗时超限)
- 工具崩溃(抛出未处理异常)
调试的核心挑战:LLM 是「黑盒」,内部思维难观测;同时智能体链路长、节点多,问题可能被层层放大。
十八、日志与分布式追踪
日志是调试的眼睛,需要记录:
- 毫秒级时间戳、当前执行节点 ID/名称;
- LLM 交互的完整 Prompt 与原始响应;
- 工具调用的名称、入参、返回结果、耗时、错误状态;
- 状态更新后的系统快照。
以 JSON 结构化日志 输出(timestamp、node、event、tool 等字段),便于自动化分析。
分布式追踪(Tracing):一次用户请求常跨越多个服务、工具与 LLM 调用,通过唯一 Trace ID 把分散日志串联成端到端调用链视图。主流工具:LangSmith(原生追踪)、OpenTelemetry(通用标准)。
根因分析:从最终错误输出反向追踪到对应 LLM 节点,查看输入,再定位上游工具/LLM 的 IO 是否异常。三类常见根因:上游工具返回非预期格式、LLM 对工具结果理解偏差、Prompt 设计模糊。
十九、调试技巧
- 隔离法(Isolation):逐步简化复杂场景,剥离非关键节点,单独测试某个工具节点,快速定位故障环节。
- 最小可复现用例(MRE):构造能稳定复现问题的最小输入,排除噪声干扰。
- 回放(Replay):保存错误案例的完整运行状态(输入、各节点 IO、状态轨迹),借 LangSmith 等平台一键还原执行流程,无需重复触发真实请求。
- 模拟(Mocking):虚拟替代外部依赖,在受控边界下测试。
- 分析思考过程(CoT):在提示词中要求模型「在行动前先解释为什么调用工具、如何提取参数」,把黑盒思考部分透明化;再对比错误案例的 CoT 与正确案例,定位判断错误环节。
小结
智能体评估是一套「指标体系 + 测试金字塔 + 自动化框架 + 回归机制」的工程体系:先定维度,再建评估集,用单元/集成/端到端三层测试落地,用 LangSmith/PromptFlow/pytest 自动化,用回归与基线守护稳定性。调试则靠结构化日志、分布式追踪和隔离复现,把黑盒问题逐步变透明。
自测题
- 为什么传统软件「一次测试、永久有效」的模式在 LLM 智能体上失效?
- 任务成功率与步骤完成率分别衡量什么?后者更适合解决什么问题?
- BLEU/ROUGE 与 LLM-as-Judge 各有什么适用场景?
- TTFT 与端到端响应时间有什么区别?各影响什么体验?
- 智能体测试金字塔的三层分别测什么?
- 简述「双人标注 + 专家仲裁」机制及其作用。
- 遇到「智能体调用了错误工具」的问题,你会按什么顺序定位根因?
答案提示:1. LLM 输出有随机性,需持续量化评估;2. 前者看整体完成比例,后者用于诊断复杂任务失败在哪个环节;3. BLEU/ROUGE 适配翻译/摘要等参考文本任务,LLM-as-Judge 适合开放性质量评估;4. TTFT 是首个字延迟、影响「是否卡顿」的第一印象,端到端是完整任务耗时;5. 单元测单个工具/提示,集成测组件协同,端到端测真实流程;6. 两人独立打分、超阈值专家仲裁,减少主观偏差;7. 从错误输出反查 LLM 节点输入 → 查上游工具 IO → 查日志与追踪 → 隔离复现。