工作流编排基础
时长:约 34 分钟(2012 秒)
本节要点
- 智能体的整体架构:用户输入 → 编排引擎 → LLM 推理 → 工具执行 → 结果返回的闭环。
- 工作流的定义,以及智能体遵循的 ReAct「思考—行动—观察」循环。
- 工作流三大基础概念:节点(Node)、边(Edge)、状态(State)。
- DAG(有向无环图)的含义、形态与核心优势。
- 常用工作流模式之一:顺序执行。
- 实操:在 Coze(扣子)平台搭建一个「销售话术多维分析」智能体,理解业务拆解 → 调用链路 → 节点选择 → 提示词编写的完整过程。
一、智能体整体架构概览
课程开篇先给出智能体的整体架构。一个智能体本质上是一个「感知 → 思考 → 行动」的闭环:
架构里有三个关键角色:
- 编排引擎:智能体的「核心大脑」。它接收用户的自然语言请求,管理任务全流程,决定什么时候让 LLM 推理、什么时候调用工具,并维护任务上下文与状态信息。
- LLM 推理:智能体的「思考单元」。它接收编排引擎的指令与当前状态进行逻辑推演,输出形式很灵活——既可以是直接的自然语言回答,也可以是结构化的工具调用指令(Function Call)。
- 工具执行:智能体的「行动单元」。它依据 LLM 给出的指令去调用外部 API(如天气、航班查询)、检索数据库或执行代码,把虚拟推理转化成实际结果。
支撑整个流程运转的三大核心组件是:
- 工作流定义:规范任务的执行路径,决定「先做什么、后做什么」。
- 工具集:构建能力资源库,决定「能做什么」。
- 状态存储器:完整记录任务过程中的上下文与关键数据,保障流程连贯性。
把这三层想清楚,是后面所有编排设计的基础。
二、什么是工作流(Workflow)
工作流是为完成特定目标而定义的、一系列相互关联的任务或步骤的有序集合。它本质上描述的是:如何把初始输入,通过既定的转换规则和操作序列,最终转化为期望的输出结果。
课程用「手冲咖啡」做类比:准备咖啡豆、滤纸、水等原料 → 研磨 → 冲泡 → 收集萃取液 → 根据口味调味。每一步都有明确的先后顺序和依赖关系,这就是一个典型的线性工作流。
智能体的工作流遵循 ReAct 模式,即「思考—行动—观察」的闭环循环:
- LLM 基于目标和当前状态,决策下一步动作(思考);
- 调用工具执行该动作(行动);
- 获取工具返回的结果进行观察反馈(观察);
- 循环往复,直到任务达成。
三、工作流编排基础概念:节点、边、状态
要理解编排,先要掌握三个最基础的原子概念。
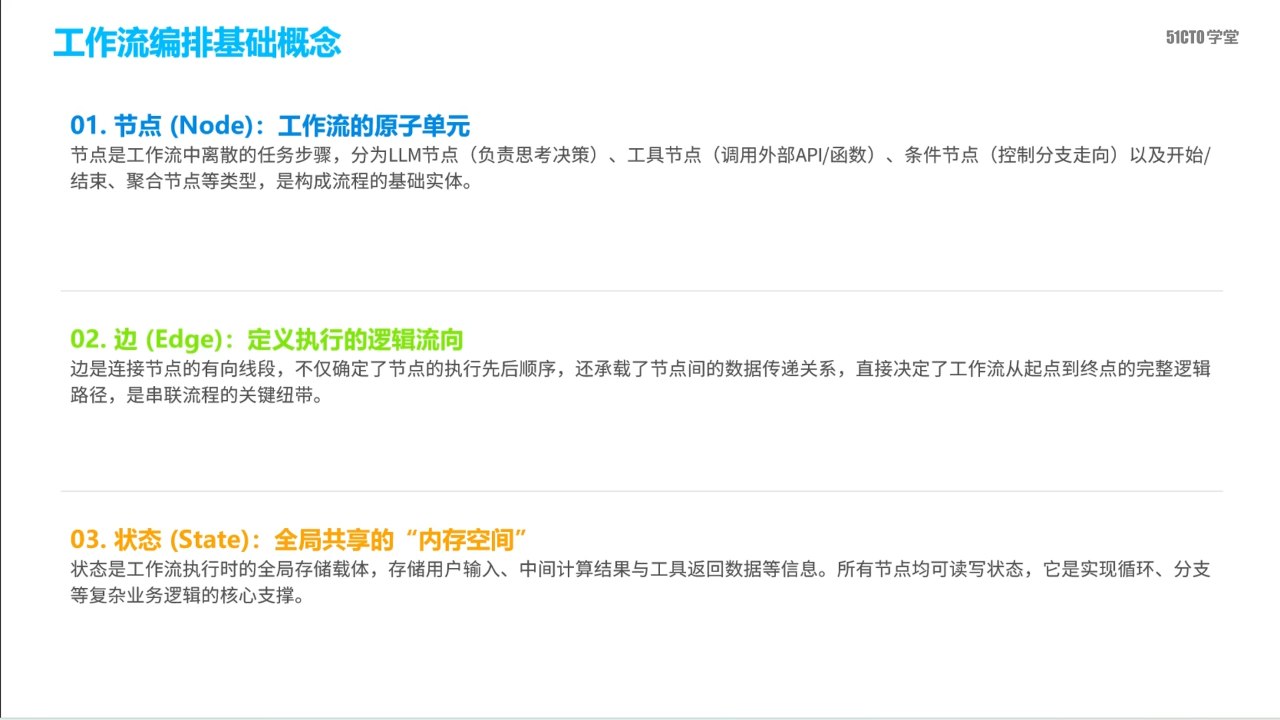
01 节点(Node)——工作流的原子单元。 节点是工作流中离散的任务步骤,常见类型包括:
- LLM 节点:负责思考决策;
- 工具节点:调用外部 API/函数;
- 条件节点:控制分支走向;
- 此外还有开始/结束节点、聚合节点等。
02 边(Edge)——定义执行的逻辑流向。 边是连接节点的有向线段,它既确定节点的执行先后顺序,也承载节点间的数据传递关系,决定了工作流从起点到终点的完整逻辑路径。
03 状态(State)——全局共享的「内存空间」。 状态存储用户输入、中间计算结果与工具返回数据等信息。所有节点都可以读写状态,它是实现循环、分支等复杂业务逻辑的核心支撑。
一句话记忆:节点决定「做什么」,边决定「按什么顺序做、数据怎么流」,状态负责「记住做过什么」。
四、DAG(有向无环图)
工作流底层的数据模型是有向无环图 DAG(Directed Acyclic Graph)。
- 「有向」:流程有明确的走向,边的方向代表执行顺序;
- 「无环」:流程不会无限循环,最终必达终点。
智能体工作流的 DAG 形态主要有三种:
- 顺序执行:线性 DAG,节点一个接一个;
- 条件分支:单节点引出多条输出边的 DAG;
- 并行执行:多个节点分流后再次汇聚的 DAG。
DAG 的核心优势:确定性让流程可预测、易调试;无环特性确保工作流可终止,避免死循环;清晰的拓扑结构让流程逻辑可视化,大幅降低设计与维护成本。
五、常用工作流模式(一):顺序执行
顺序执行是最基础的工作流模式:节点严格遵循预先定义的线性路径依次运行,前一个节点执行完毕后,后续节点才会触发,呈现「Node A → Node B → Node C」的单一走向。
典型场景是任务间存在明确线性依赖的业务。例如旅行行程规划:先获取用户出行需求,再依次查询对应航班信息、匹配目的地酒店资源,最后整合数据生成完整行程方案——步骤不可跳跃,也不可并行。
优点:逻辑简单直观,易于设计、实现与维护;执行路径唯一、确定性高,测试和结果预测难度低。
缺点:缺乏灵活性,无法适配复杂的分支判断;全程串行执行,无法利用并行处理提升效率,整体耗时较长。
六、实操:在 Coze 搭建「销售话术多维分析」智能体
后半节课围绕一个完整案例展开:给销售人员搭建一个「销售话术多维分析」智能体,输入销售对话记录,输出话术分析报告和优化建议。
6.1 先想清楚业务
做任何 AI 项目之前,先要把业务想清楚。课程给出了拆解业务的 5 个核心问题,把模糊需求拆成可量化、可执行的目标:
- 分析什么? 销售对话的话术质量(开场、需求挖掘、产品介绍、异议处理、逼单等维度);
- 怎么分析? 用大模型做语义理解 + 结构化输出;
- 输出什么? 多维评分 + 具体问题点 + 改进建议;
- 给谁看? 销售本人看成长,销售主管看团队质检;
- 落到什么约束? 搭建工作流 + 搭建智能体。
「多维」具体展开为:开场白、需求挖掘、产品介绍、异议处理、逼单/促成、沟通技巧等维度。
6.2 设计调用链路与工作流步骤
整体调用链路是:用户说话 → 智能体识别意图 → 智能体调用工作流 → 工作流处理并返回结果 → 智能体回复用户。
设计原则小结:先想清楚业务 → 设计调用链路 → 拆工作流步骤 → 再动手搭节点。
这里有一个关键思想:工作流不是「一个节点搞定所有事」,而是分层处理:
- 结构化输出:第一次让大模型按 JSON 输出各维度评分(便于机器处理);
- 人性化润色:第二次让大模型把 JSON 翻译成易读的报告(给人看)。
分层的好处是「结构稳定 + 表达灵活」——后续要加维度,只需要改第一个节点的提示词。
6.3 大模型节点的提示词设计
核心的大模型节点,系统提示词包含四部分:
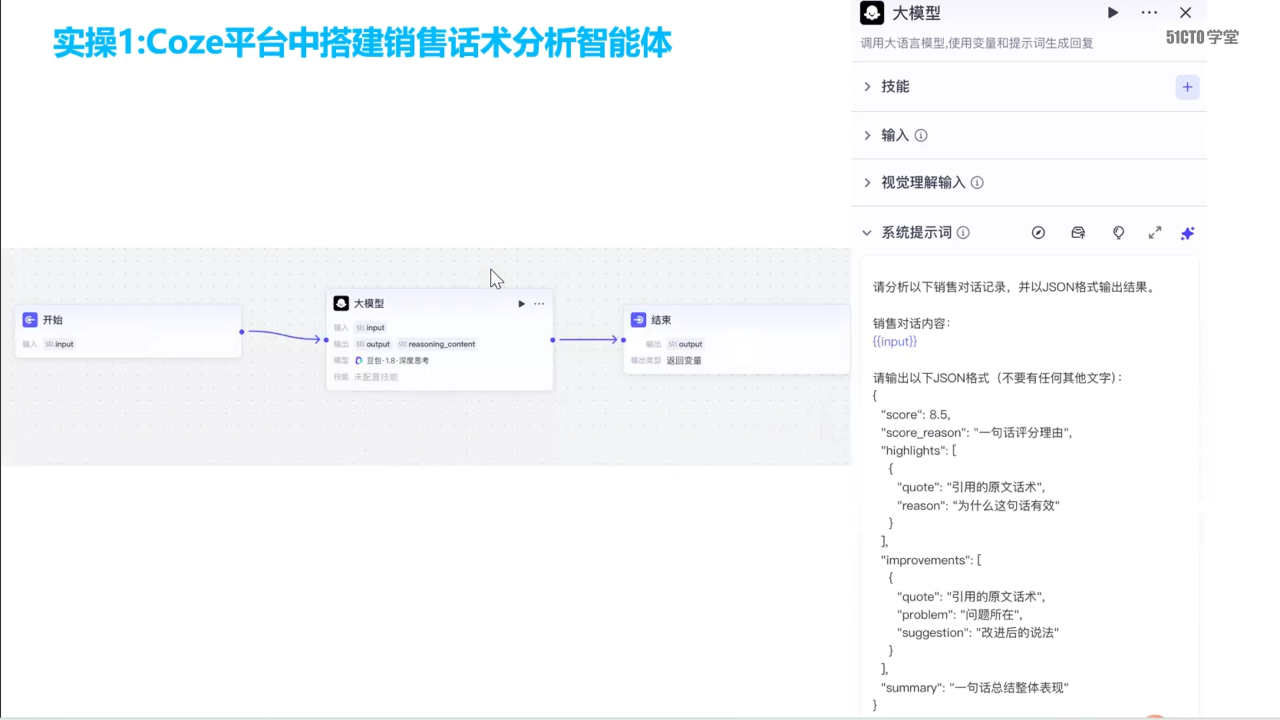
- 角色:资深销售培训分析师,专门分析销售聊天对话,输出专业话术分析报告;
- 任务:阅读输入对话,从 5 个维度分析;
- 技能:话术结构完整性、需求挖掘、产品价值呈现、异议处理、促成策略;
- 限制:仅基于用户提供的对话文本分析,引用原文关键句作为支撑,输出需包含「优势亮点 + 问题清单 + 优化话术示例」三部分。
同时要求:给出综合打分(满分 100 分)、分点输出 5 个维度的分析、最后输出 3~5 条可直接落地的优化话术建议。
小结
这一课建立了智能体工作流的完整认知框架:架构闭环(编排引擎 + LLM + 工具执行)→ 工作流与 ReAct 循环 → 节点/边/状态三要素 → DAG 数据模型 → 顺序执行模式 → Coze 实操。核心方法论是「先想清楚业务,再设计调用链路,最后拆节点写提示词」,并记住「分层处理」——机器处理的 JSON 和给人看的报告分开交给大模型完成。
自测题
- 请画出智能体整体架构的闭环,并说明编排引擎、LLM 推理、工具执行各自扮演什么角色。
- ReAct 模式中的「思考—行动—观察」分别对应什么过程?
- 工作流的节点、边、状态三个概念分别解决什么问题?各自承担什么职责?
- 为什么说 DAG 的「无环」特性对工作流很重要?顺序执行、条件分支、并行执行在 DAG 上各呈现什么形态?
- 在销售话术分析案例中,为什么要把「结构化 JSON 输出」和「人性化润色报告」拆成两次大模型调用,而不是一个节点搞定?
答案提示:1. 用户输入 → 编排引擎 → LLM 推理 → 工具执行 → 结果返回;编排引擎统筹调度,LLM 负责思考决策,工具执行负责实际动作。2. 思考=决策下一步动作,行动=调用工具执行,观察=读取工具返回结果。3. 节点定义「做什么」,边定义「顺序与数据流」,状态负责「记住上下文」。4. 无环保证流程可终止、不陷入死循环;顺序=线性 DAG,分支=单节点多输出边,并行=分流后汇聚。5. 结构稳定 + 表达灵活,机器处理与人类阅读分离,后续加维度只改第一个节点。