使用Dify低代码搭建知识库问答智能体实操
时长:约 41 分钟
学习目标
- 完整走一遍“内部制度问答助手”的搭建流程。
- 掌握文档上传、切分、索引、召回测试和提示词配置的实际操作。
- 能根据测试结果定位“召回不到、答偏、编造、引用缺失”等问题。
- 了解从调试到发布、再到持续优化的闭环。
一、场景与数据准备
课程用一个企业内网场景:员工经常询问差旅标准、考勤规则、费用报销、人事流程和员工福利。目标是做一个“公司内部制度问答助手”,让员工自助查询,减少人工答疑。
准备的数据是 5 份 PDF:
- 差旅管理制度
- 考勤管理制度
- 费用报销制度
- 人事管理制度
- 员工福利制度
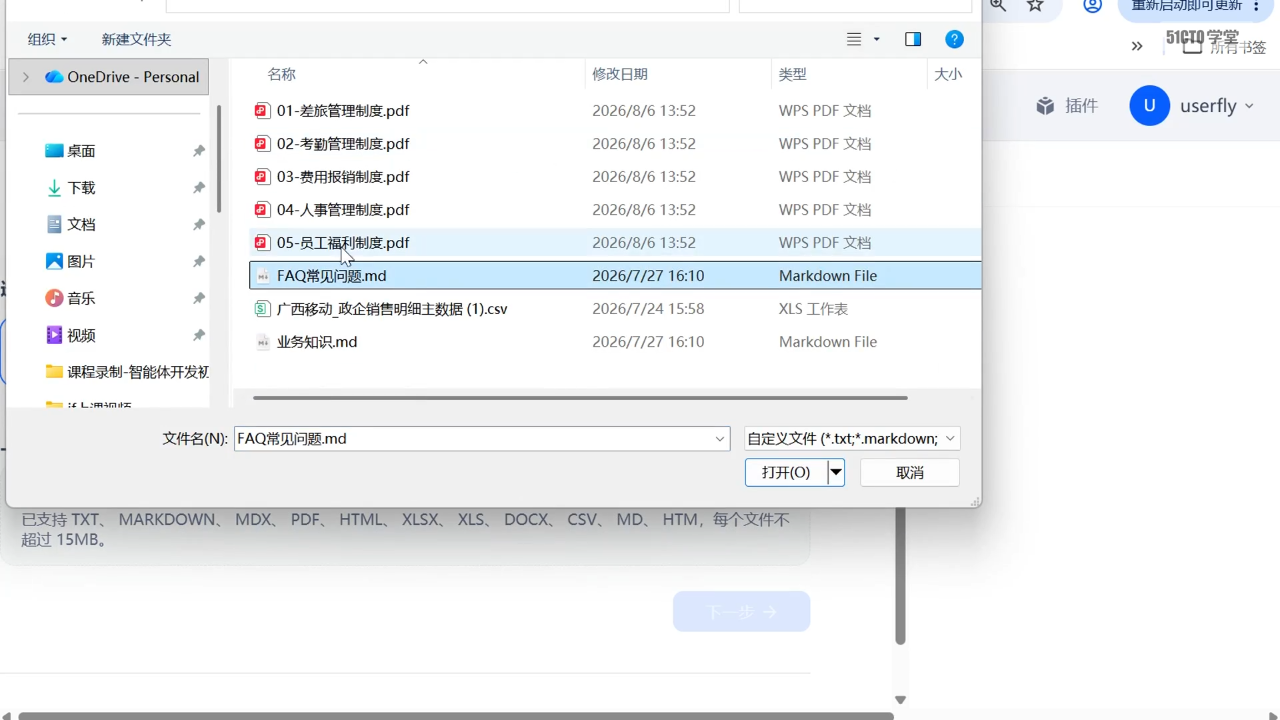
数据准备阶段要检查:
- 文件是否为最新版;
- 扫描件是否需要 OCR;
- 页眉页脚、目录、空白页是否清洗;
- 同一制度是否有多个版本,避免旧版混入。
二、创建知识库与选择索引方式
在 Dify 中新建知识库,命名为“公司制度库”,批量上传 5 份 PDF。
索引方式通常有两种:
- 高质量:调用 Embedding 模型生成向量,检索更准确,但有 Token 成本。
- 经济:用关键词索引,成本低,但语义召回能力弱。
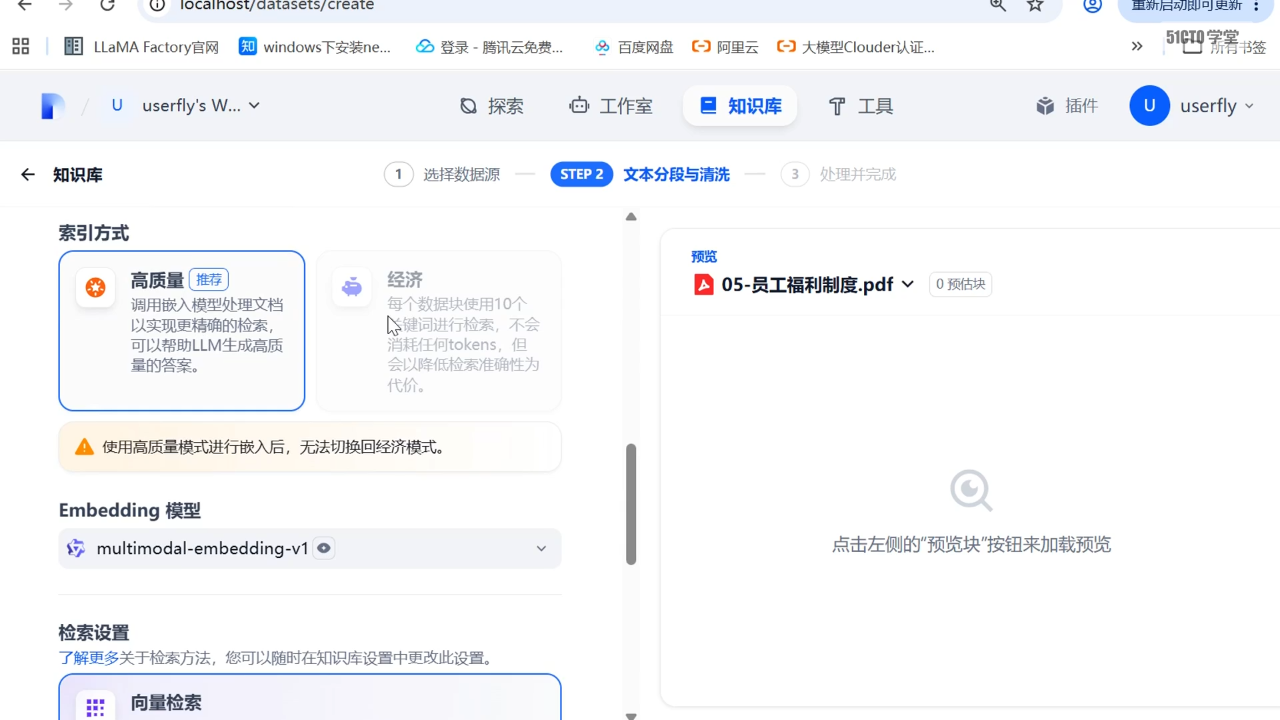
如果业务问题是“年假多少天”“出差住宿标准”这类语义问法,优先选高质量向量索引。注意:高质量模式建立后通常不能直接切回经济模式,建库前要想清楚。
三、文本分段与清洗
分段参数直接决定召回质量。课程中的起点是:
- 分段最大长度约 500 Token;
- 保留一定重叠,避免上下文被生硬切断;
- 优先按标题、段落、问答对切分。
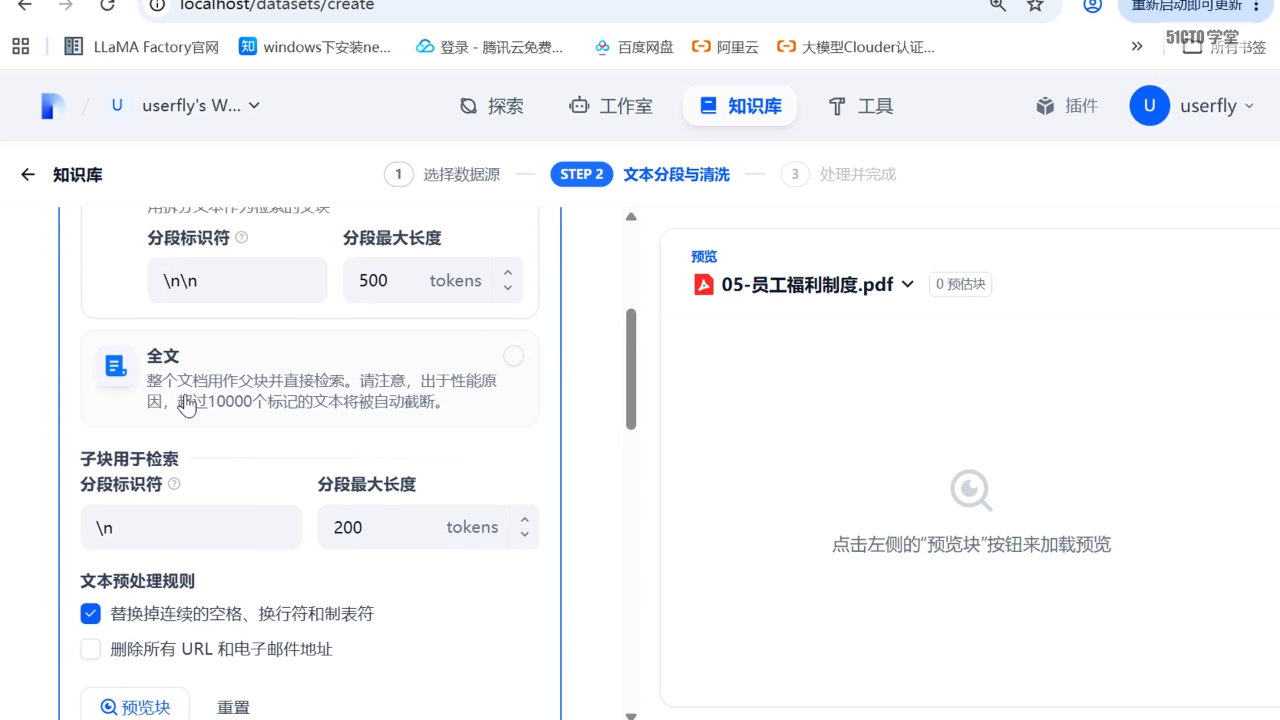
切分后要预览实际片段,重点检查:
- 一条制度是否被切成多个不完整的句子;
- 标题和正文是否分离;
- 表格是否被破坏;
- 关键数字、日期、金额是否落在片段内。
四、召回测试
建库完成后,先用“召回测试”验证检索,不要急着接 LLM。
建议准备三类查询:
| 查询 | 目的 |
|---|---|
| “年假有多少天?” | 验证库内标准问题 |
| “出差住宿标准是多少?” | 验证数字与条款召回 |
| “食堂在哪里?” | 验证库外问题的拒答边界 |
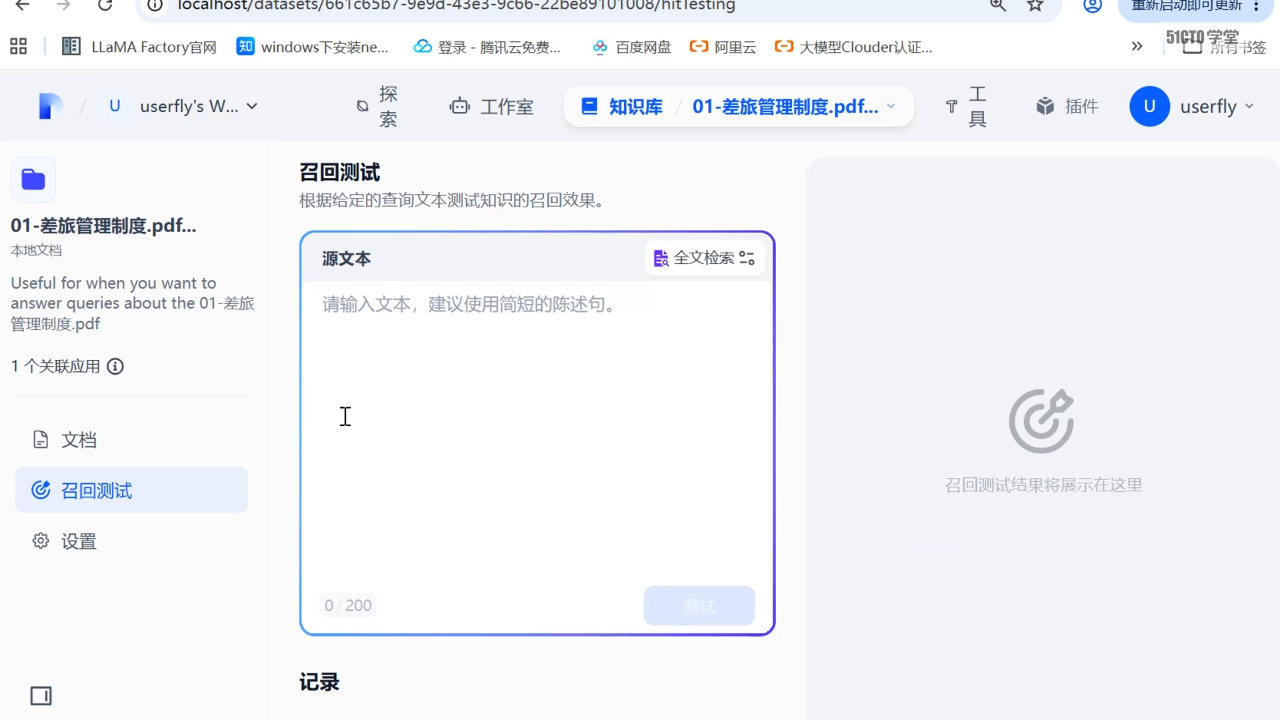
如果召回不到正确片段,优先调整:
- 分段长度与重叠;
- 索引方式与 Embedding 模型;
- 检索策略(向量/关键词/混合);
- Top-K 与相似度阈值。
五、编排问答流程
课程中的流程可以还原为:
LLM 系统提示词建议:
六、测试与调优
课程给出两个核心测试场景:
场景一:库内问题
提问:“公司规定的年假有多少天?”
预期:召回《员工考勤与休假管理办法》,给出具体天数,并标注来源。
场景二:库外问题
提问:“公司食堂具体在园区哪个位置?”
预期:明确回复“知识库中暂未收录相关信息”,不编造位置。
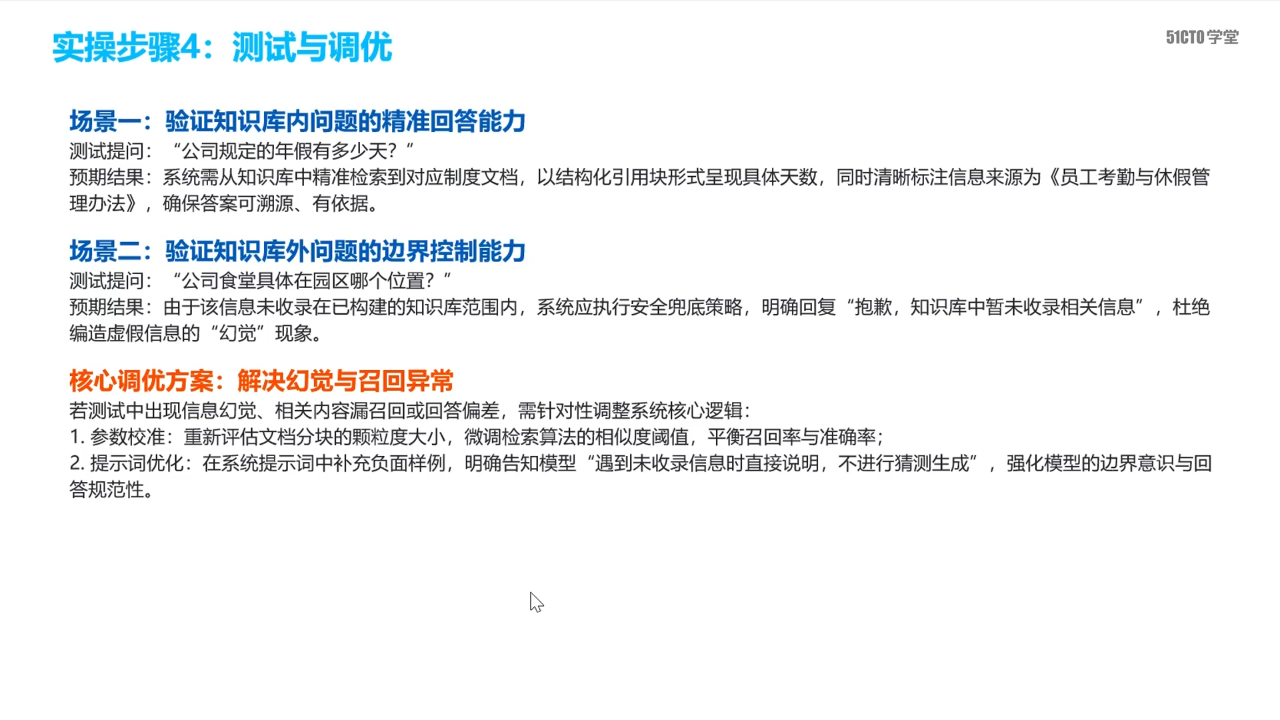
出现问题时按这个顺序排查:
- 召回异常:看命中的片段是否包含答案;没有就调分段、索引和检索参数。
- 答偏:看 Prompt 是否把用户问题和片段正确拼接。
- 编造:加强“只依据检索内容”和“无依据拒答”的约束。
- 引用缺失:要求模型输出文档名、章节或片段编号。
七、发布与接入
课程演示了三种发布方式:
- Web 应用:生成访问链接,可设置密码,适合内部试用。
- API 端点:接入企业自有系统。
- 嵌入网站:用 iframe 或脚本嵌入现有页面。
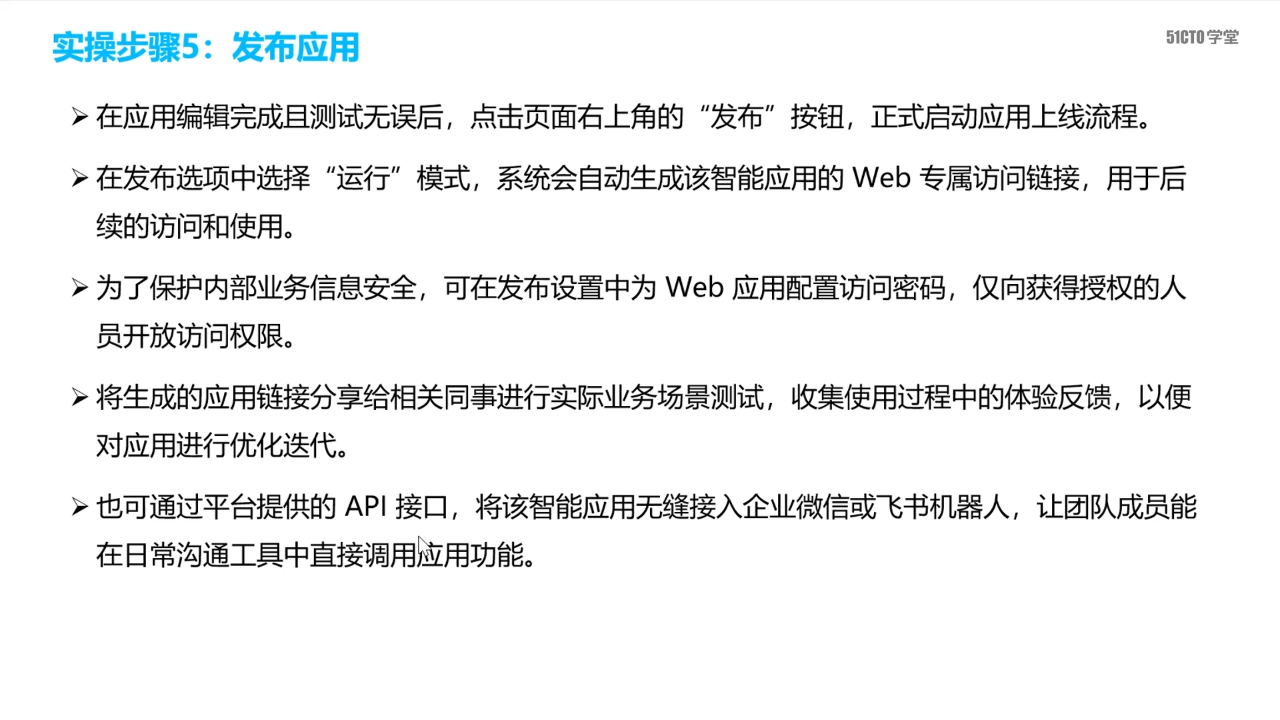
上线前至少完成:
- 20+ 条代表性问题的回归测试;
- 库内、库外、边界和敏感问题测试;
- 延迟、Token 成本和失败率评估;
- 版本记录与回滚方案。
八、持续优化闭环
一个知识库助手不是“发布即结束”,而是持续循环:
重点监控:
- 哪些问题召回不到;
- 哪些回答被用户追问或否定;
- 哪些文档长期未更新;
- 哪些查询 Token 成本异常高。
九、常见坑
- 直接把旧版制度也上传,导致模型召回过期条款。
- 分段太碎,答案被切成几段,模型只看到半句话。
- 只测“标准问法”,不测口语化和同义表达。
- 库外问题没有兜底话术,模型自由编造。
- 发布后不收集真实问题,知识库逐渐与业务脱节。
十、自测题
- 内部制度助手需要准备哪些类型的文档?
- 高质量索引与经济索引的核心差别是什么?
- 分段后为什么要预览实际片段?
- 召回不到答案时,应该先调哪些参数?
- 库外问题的预期行为是什么?
- 上线后的持续优化闭环包含哪些环节?
答案提示:1. 差旅、考勤、报销、人事、福利等最新制度;2. 是否用 Embedding 做语义向量检索;3. 检查语义完整性、数字和表格是否被破坏;4. 分段、索引、检索策略、Top-K/阈值;5. 明确拒答并建议咨询,不编造;6. 收集问题、修订文档、重建索引、回归测试、监控反馈。
本节小结
这一节把前面学的 RAG、Dify 工作流和调试方法串成了一个可交付项目:准备最新制度文档,选择合适索引,切分并检查片段,先做召回测试,再编排检索与 LLM 节点,用库内/库外问题验证,最后发布并持续收集反馈。真正决定效果的往往不是“模型多强”,而是文档质量、切分粒度和检索参数。