RAG技术基础以及低代码平台工具
时长:约 58 分钟
学习目标
- 理解 RAG 要解决的核心问题:模型不知道企业私有知识、知识会过时。
- 能完整复述 RAG 的离线建库与在线检索两条链路。
- 掌握文档切分、Embedding、相似度检索、上下文拼接的关键取舍。
- 了解 Dify、Coze 等低代码平台如何把 RAG 封装成知识库与工作流节点。
一、为什么需要 RAG
通用大模型有两个天然限制:
- 数据不可达:训练数据有截止时间,也无法直接访问企业内部的文档、工单和数据库。
- 知识会过时:模型训练完成后参数固定,不能自动知道最新制度、产品和价格。
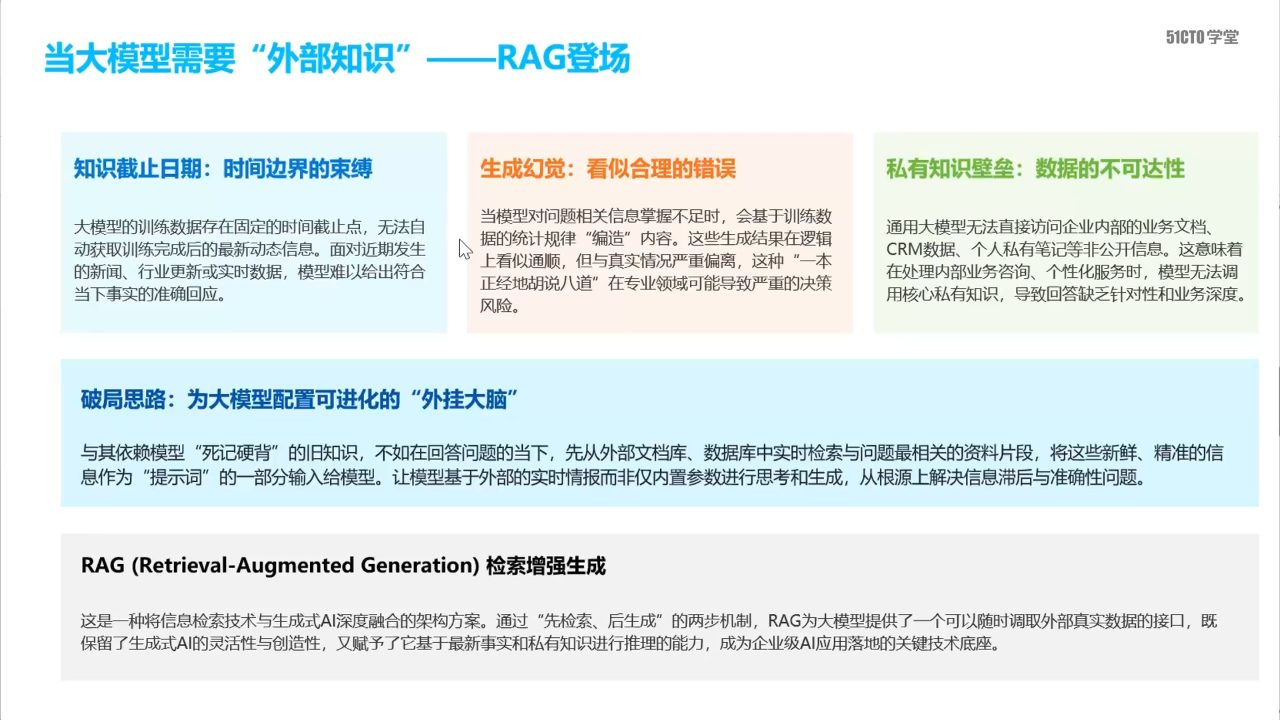
RAG(Retrieval-Augmented Generation,检索增强生成)的思路是:回答之前先查资料,再把查到的资料和问题一起交给模型生成答案。
这样做有三个直接收益:
- 降低幻觉:答案有真实文档作依据。
- 知识可更新:改知识库即可,不必重新训练模型。
- 可追溯:能定位答案来自哪一段资料。
二、RAG 的两条链路
离线建库
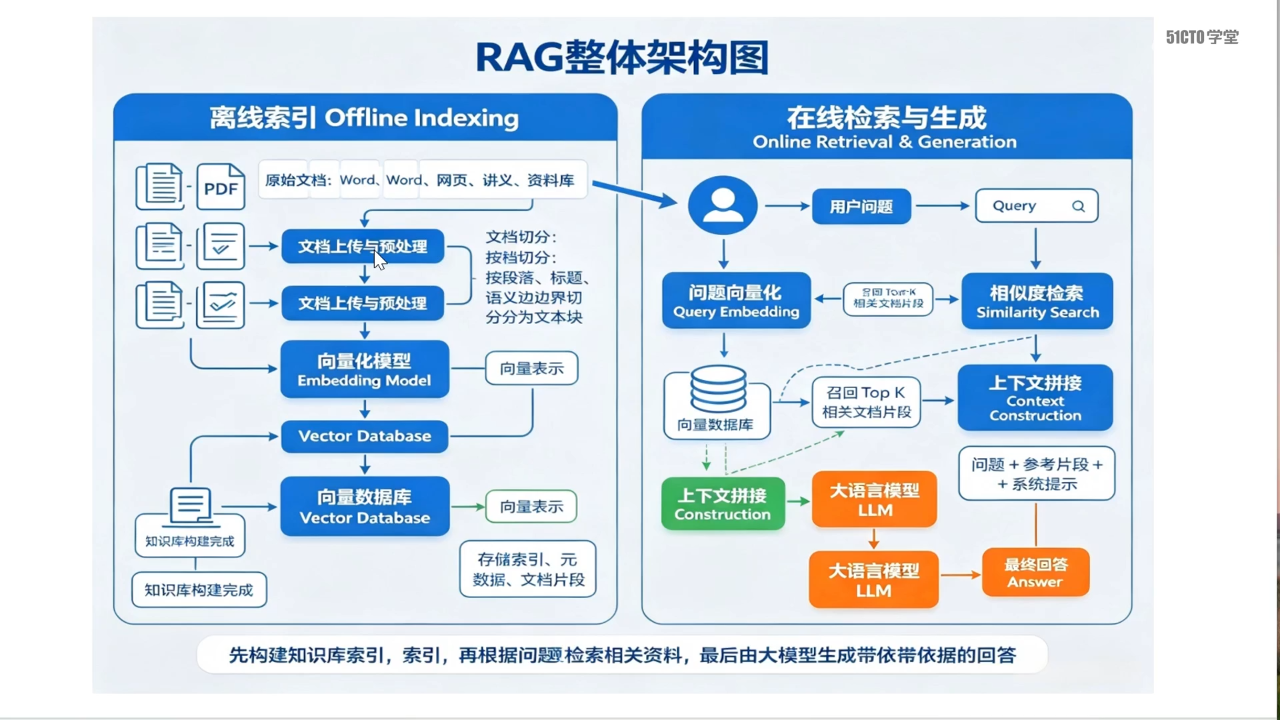
在线检索
两条链路必须使用同一套 Embedding 模型,否则问题向量和文档向量不在同一个语义空间,检索会失准。
三、文档切分:RAG 效果的分水岭
切分(Chunking)决定了每个检索单元的大小。切得太大,噪声多、Token 成本高;切得太小,上下文断裂、答案不完整。
课程给出的实践区间是:
- 单个文本块约 500–1000 Token;
- 相邻块保留约 10% 重叠;
- 优先按标题、段落、问答对等语义边界切分,避免把一句话从中间截断。
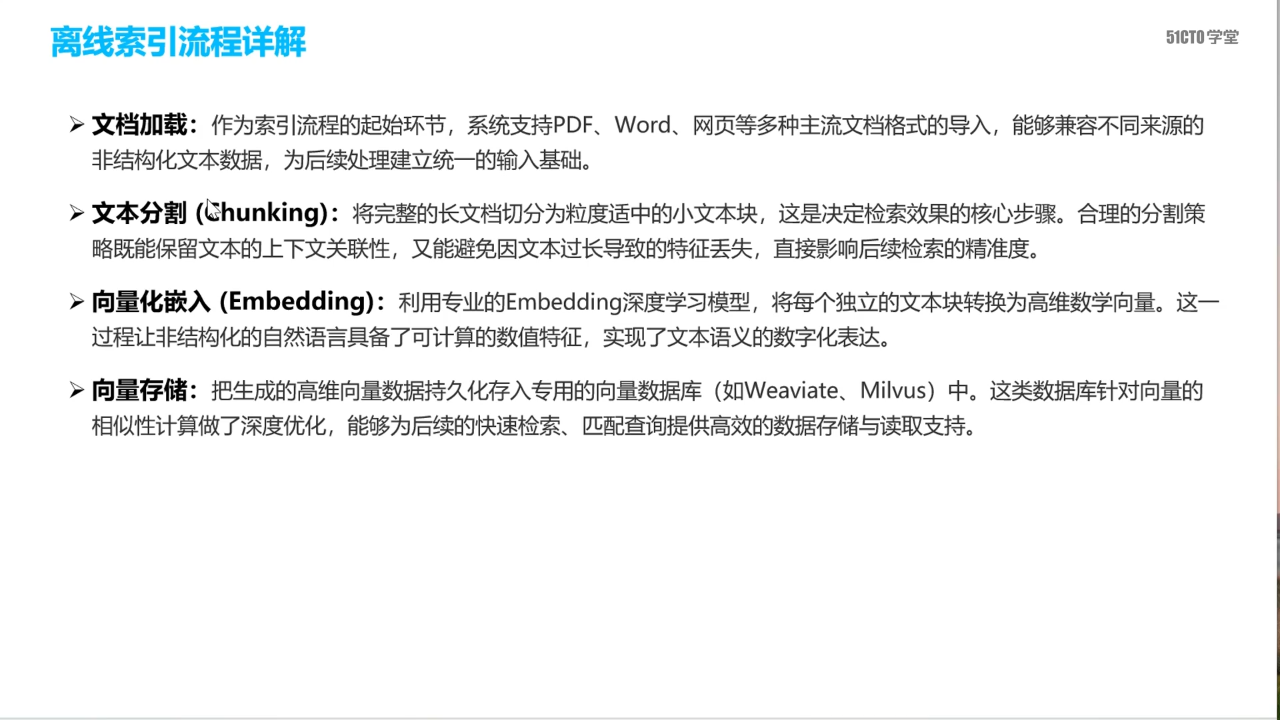
切分时还要考虑:
- 表格、图片、扫描件是否需要 OCR 或结构化解析;
- 文档标题、章节号、更新时间等元数据是否保留;
- 中英文混合内容是否需要多语言 Embedding 模型。
四、Embedding 与相似度检索
Embedding 把文本映射成高维向量,语义越接近的文本,向量距离通常越小。检索时常用余弦相似度衡量问题向量与文档片段向量的接近程度。
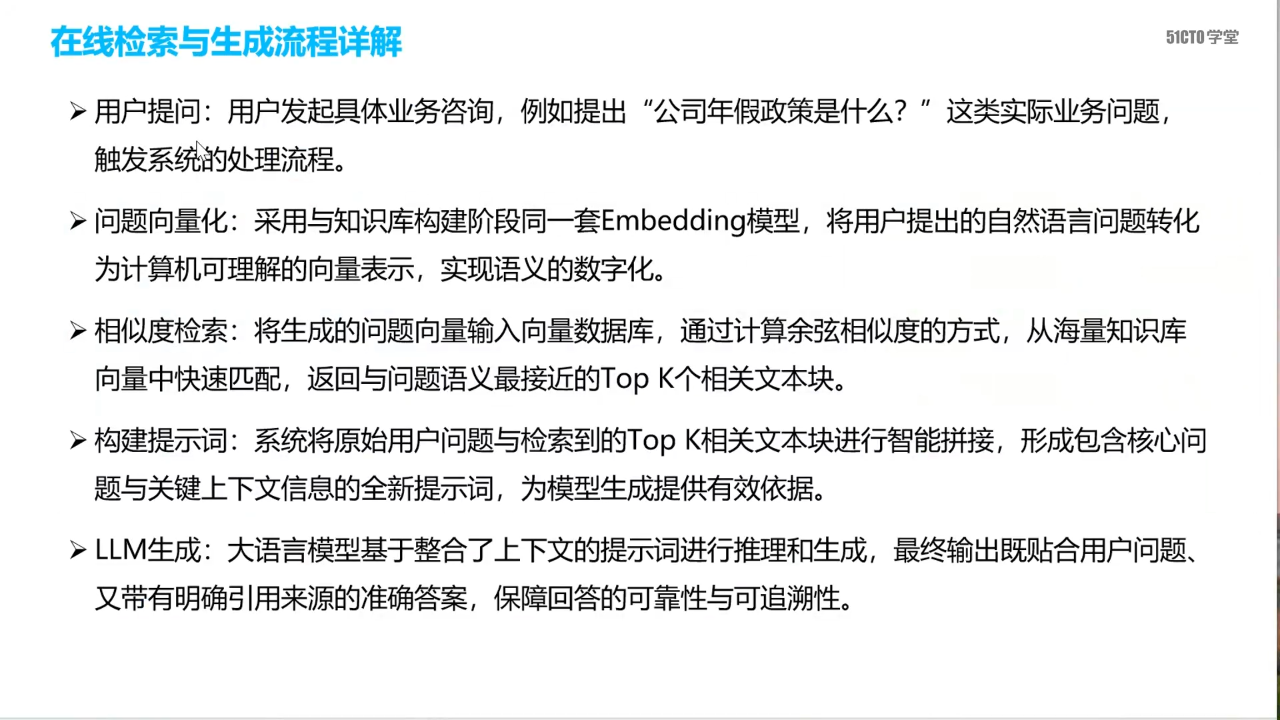
常见优化手段:
- Top-K:先召回 K 个候选片段,再交给模型。
- 重排序(Rerank):用更精细的模型对候选片段重新排序。
- 混合检索:向量检索 + 关键词检索,兼顾语义与专有名词。
- 元数据过滤:按部门、文档类型、时间范围先缩小范围。
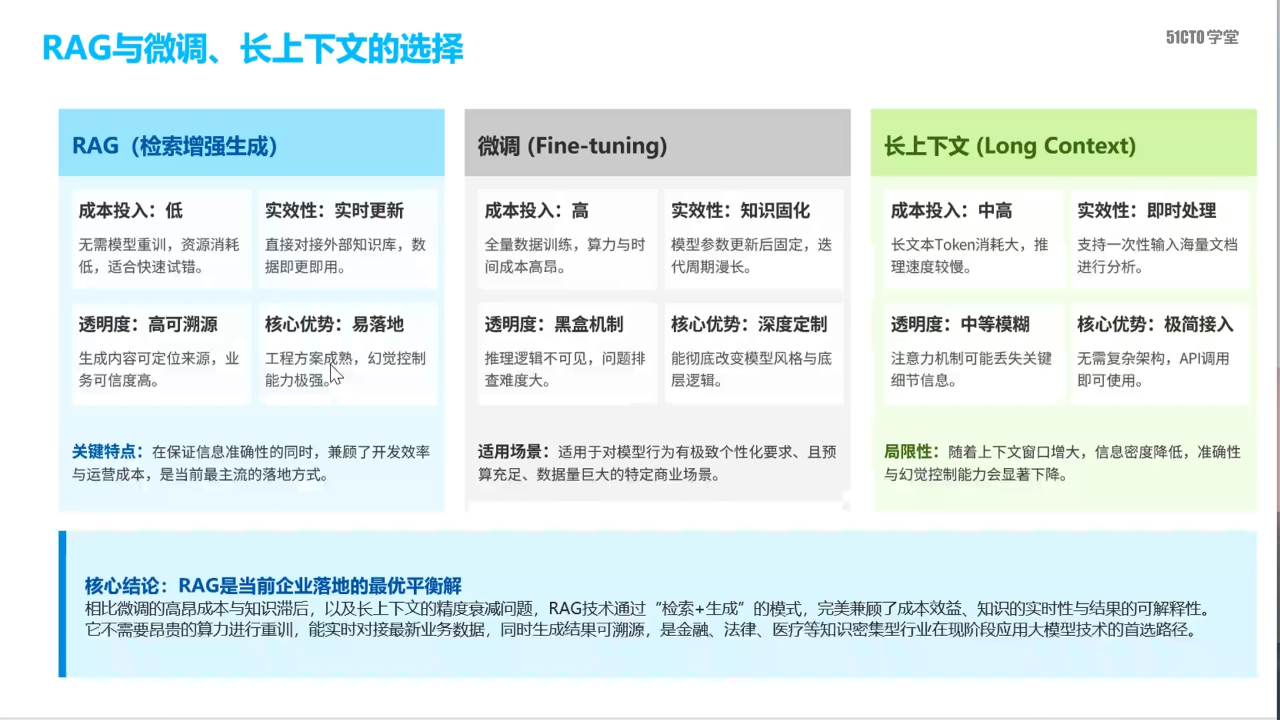
五、RAG 与微调的取舍
| 维度 | RAG | 微调 |
|---|---|---|
| 知识更新 | 改知识库即可,实时性好 | 需要重新准备数据并训练 |
| 成本 | 主要是检索与推理成本 | 训练算力与数据标注成本高 |
| 适合场景 | 企业文档问答、制度查询、客服知识库 | 固定风格、固定任务格式、领域能力强化 |
| 可追溯性 | 能定位引用片段 | 知识固化在参数里,难追溯 |
一个常见组合是:用 RAG 解决“知道什么”,用微调解决“怎么说得像”。
六、在 Dify 中搭建知识库问答
课程演示了 Dify 的完整操作链路:
- 创建知识库,选择数据源(本地文档、在线网页、公众号等)。
- 上传文档并设置分段长度、重叠长度和 Embedding 模型。
- 等待索引完成,检查召回效果。
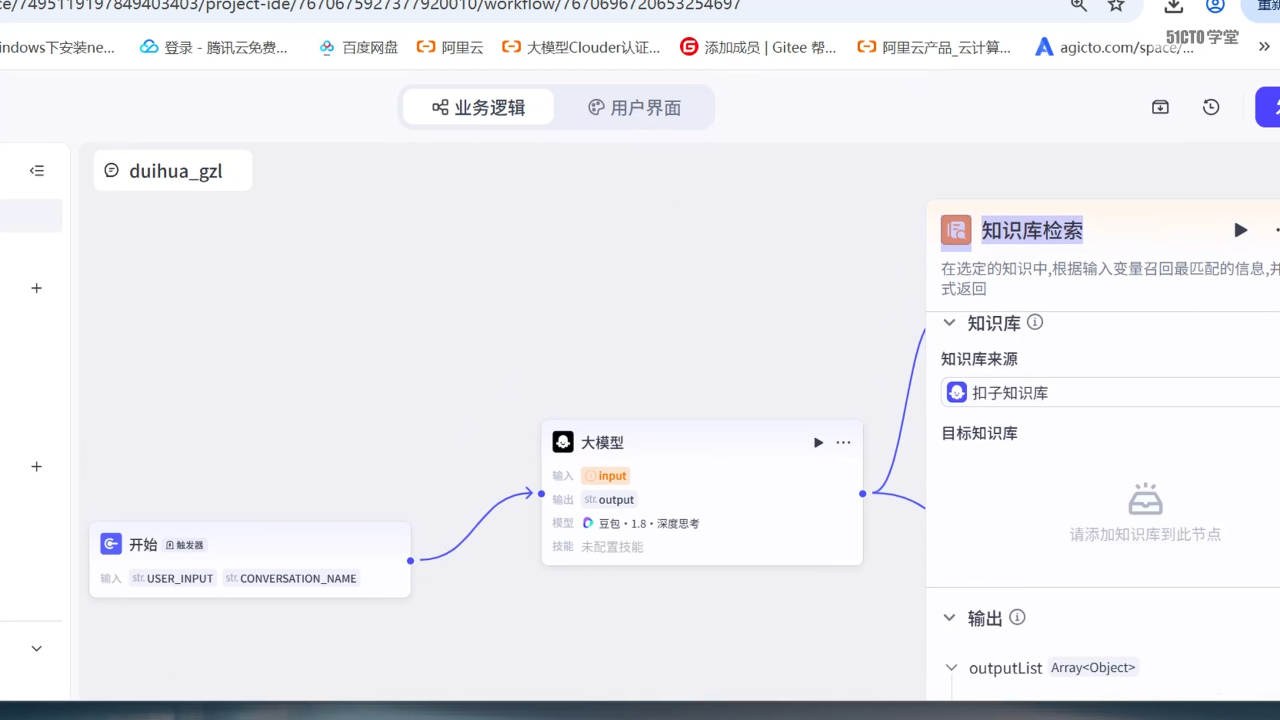
- 创建 Chatflow 或工作流,加入「知识库检索」节点。
- 把检索结果接入 LLM 节点,并在提示词中要求“只依据检索内容回答”。
- 在预览区测试,观察召回片段与最终回答。
一个可靠的回答提示词可以写成:
七、Coze 的工作流节点
课程还演示了 Coze 工作流中的常见节点:
- 开始:接收用户输入。
- LLM:调用大模型完成理解、分类或生成。
- 知识库检索:按输入变量召回知识片段。
- 插件:调用外部 API 或平台能力。
- 条件分支:按意图、关键词或变量值走不同路径。
- 文本处理 / 代码:清洗、拼接、格式转换。
- 变量聚合 / 批处理 / 异步任务:处理多路结果和并发任务。
- 结束:返回最终结果。
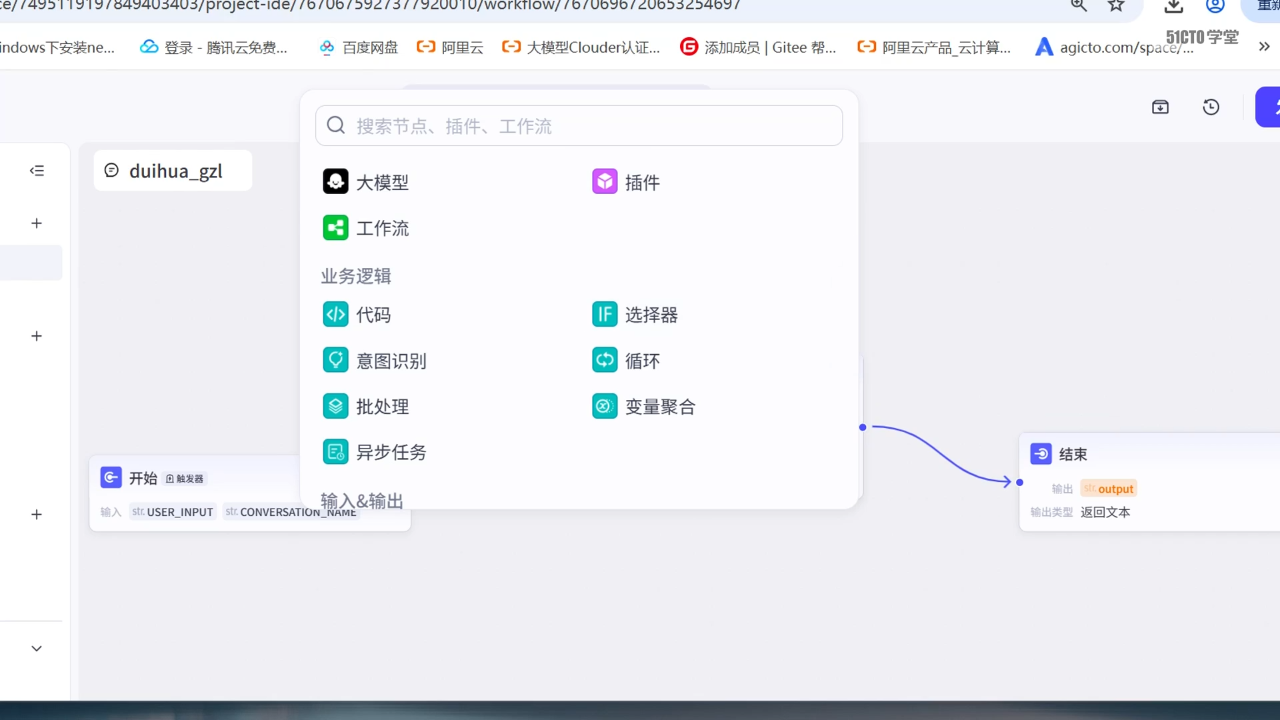
工作流的核心不是“节点越多越好”,而是让每一步的输入输出都可预测、可调试。
八、常见坑
- 文档切得过大或过小,导致召回不准或上下文断裂。
- 建库和检索用了不同的 Embedding 模型。
- 只做向量检索,不做关键词或元数据过滤,专有名词召回差。
- 提示词没有约束“只依据检索内容”,模型仍然自由发挥。
- 知识库长期不更新,答案与最新制度脱节。
- 不做引用和可追溯,出错时无法定位是哪段资料的问题。
九、自测题
- RAG 主要解决大模型的哪两类知识问题?
- 画出 RAG 的离线建库和在线检索两条链路。
- 为什么建库和检索必须使用同一个 Embedding 模型?
- Chunk 太大和太小分别有什么问题?
- RAG 与微调各自适合什么场景?
- 知识库问答的提示词里,为什么要加“没有依据就说不知道”?
答案提示:1. 私有数据不可达、知识会过时;2. 见上文两条链路;3. 否则向量不在同一语义空间;4. 太大噪声多、太小上下文断裂;5. RAG 适合动态知识,微调适合固定风格/任务;6. 降低幻觉并保持可追溯。
本节小结
RAG 的本质是“先检索、再生成”:把企业文档切成合适的片段,用 Embedding 建索引,在线时召回最相关的片段,再让模型基于证据回答。低代码平台把这套流程封装成知识库和可视化节点,但切分、Embedding、召回和提示词约束仍然决定最终效果。