LLM-API基础调用
时长:约 23 分钟
学习目标
- 理解为什么智能体的核心能力最终都要落到“调用大模型 API”上。
- 能说清一次 LLM API 请求的输入、输出和关键参数。
- 知道 API Key、Base URL、模型名称分别解决什么问题。
- 能读懂一段最小的 Python 调用代码,并知道常见报错该从哪里查。
一、为什么智能体开发必须掌握 API
无论使用 Dify、Coze 这类低代码平台,还是用 Python 自己写,智能体的“大脑”本质上都是通过调用大模型 API 完成推理与决策。
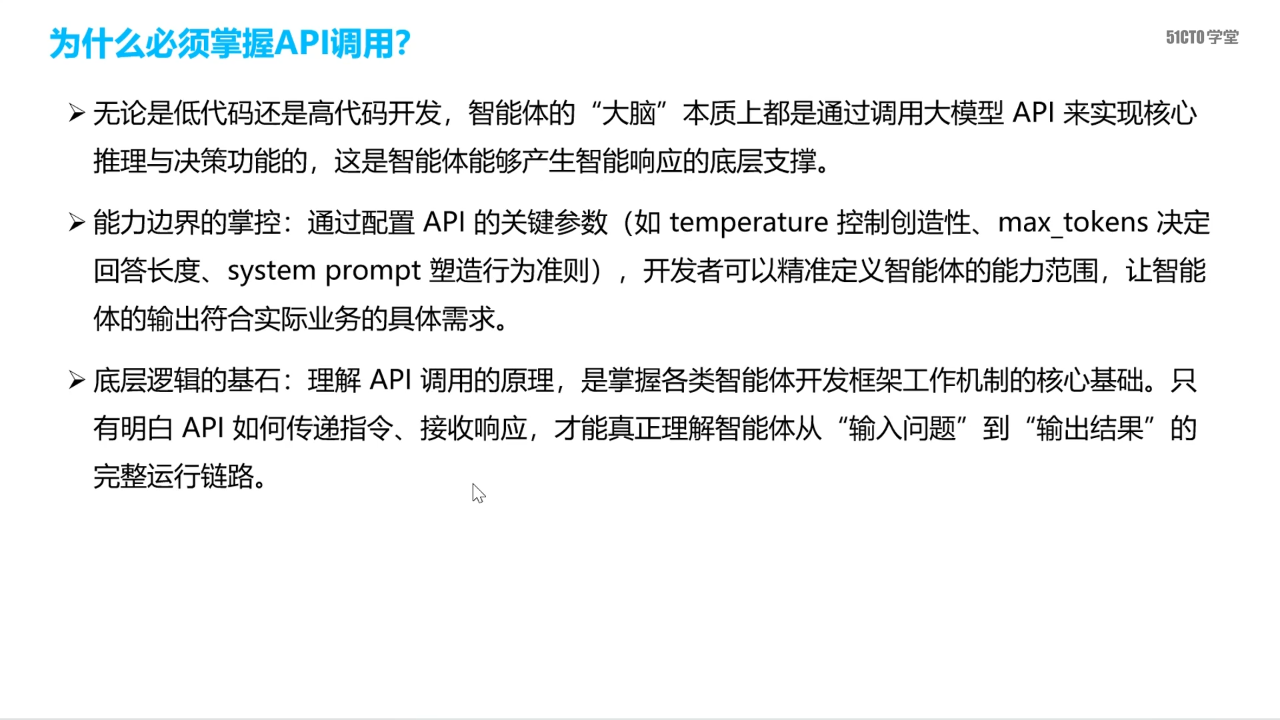
掌握 API 有三个直接价值:
- 控制能力边界:通过
temperature、max_tokens、system prompt等参数,决定模型有多发散、回答多长、扮演什么角色。 - 理解底层链路:知道请求如何把指令送进模型、响应如何把结果带回来,才能理解各种智能体框架的工作原理。
- 具备迁移能力:主流平台大多兼容 OpenAI 的 Chat Completions 调用格式,学会一种,切换到其它模型时成本很低。
二、LLM API 是什么
LLM API 是软件与云端大模型交互的 HTTP 接口。客户端把提示词和参数放进请求,服务端完成语义理解与内容生成,再把结构化结果返回。
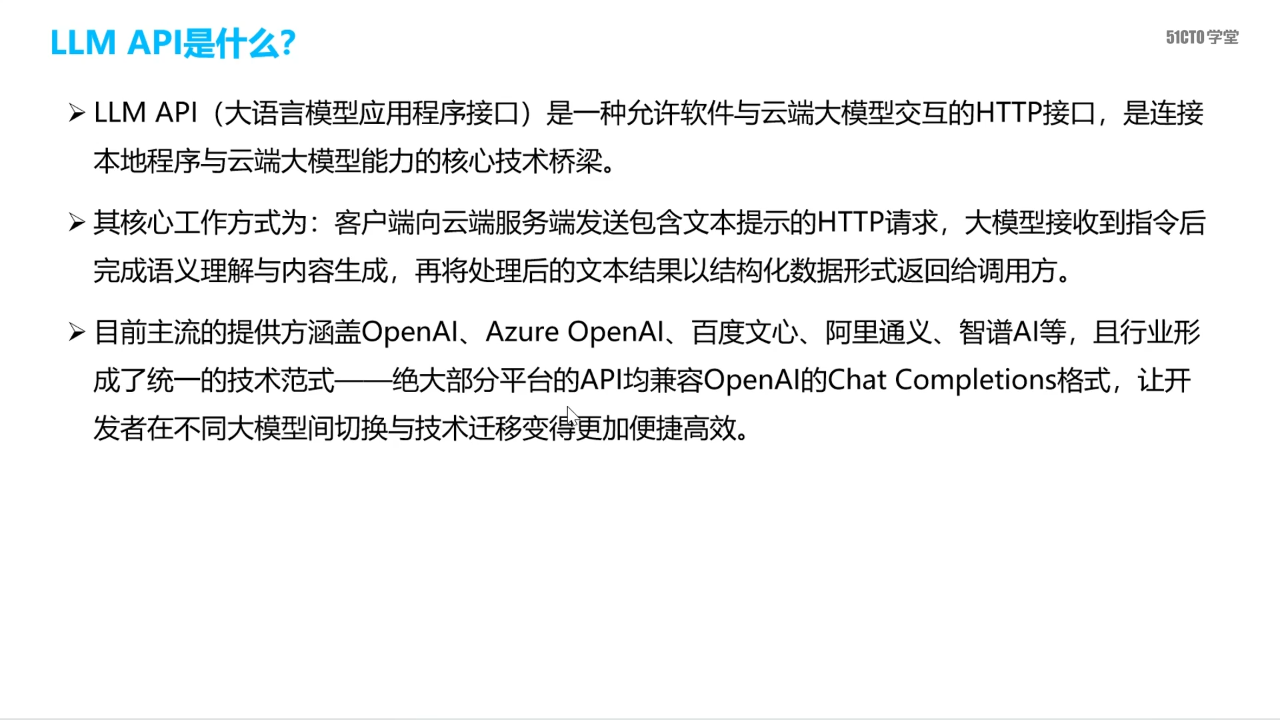
可以把它想成一条固定的数据链路:
课程提到的主流提供方包括 OpenAI、Azure OpenAI、百度文心、阿里通义、智谱 AI 等。不同平台的接口细节有差异,但“消息进、文本出”的基本范式一致。
三、请求体与响应体
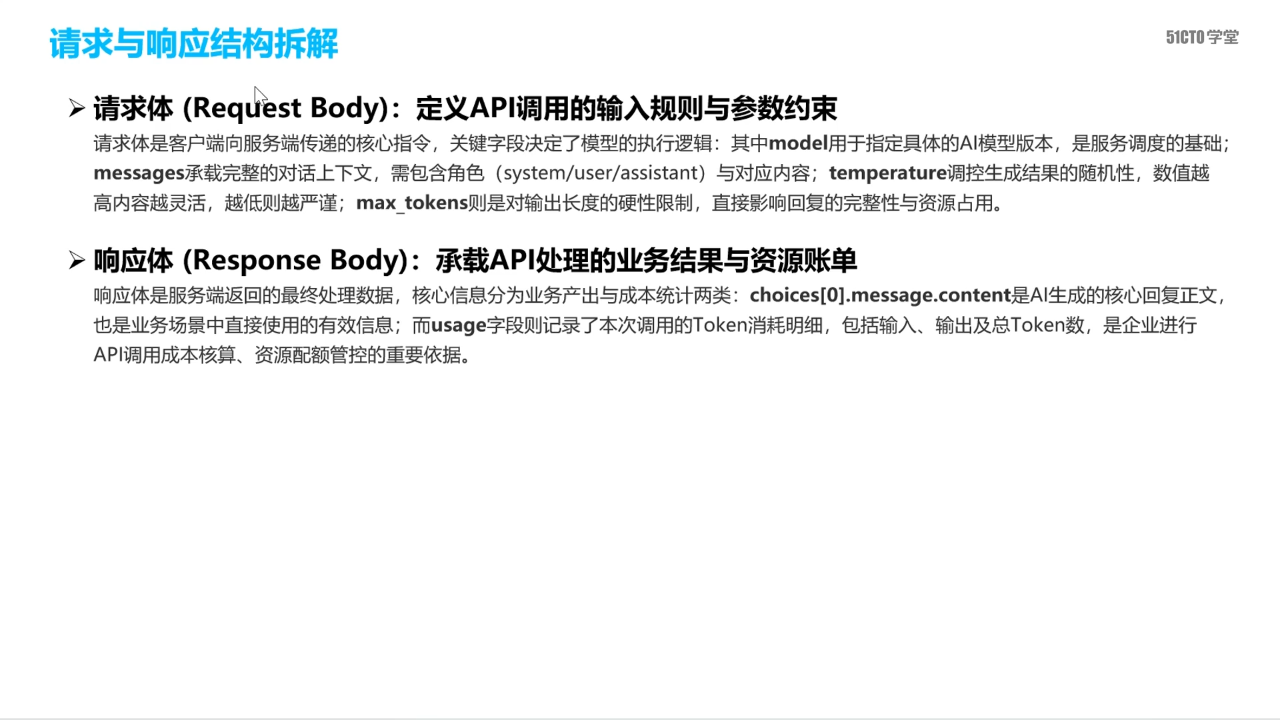
请求体里最重要的字段
| 字段 | 作用 | 记忆方式 |
|---|---|---|
model | 指定调用哪个模型版本 | “找谁干活” |
messages | 承载完整对话上下文,每条包含 role 和 content | “把前因后果说清楚” |
temperature | 控制随机性:越高越发散,越低越稳定 | “创意旋钮” |
max_tokens | 限制输出长度,也影响成本和完整性 | “回答上限” |
messages 常见角色:
system:设定身份、边界和行为准则。user:用户本轮输入。assistant:模型之前的回复,用于多轮对话。
响应体里最重要的字段
choices[0].message.content:模型生成的正文,是业务真正要用的内容。usage:本次调用的 Token 消耗,包括输入、输出和总数,是成本核算与配额管理的依据。
四、API Key 与鉴权
API Key 是调用大模型能力的“数字钥匙”,关联着接口权限、额度与费用。标准流程是:注册并实名认证 → 在控制台创建 Key → 设置额度和消费预警 → 在请求头中携带 Key。
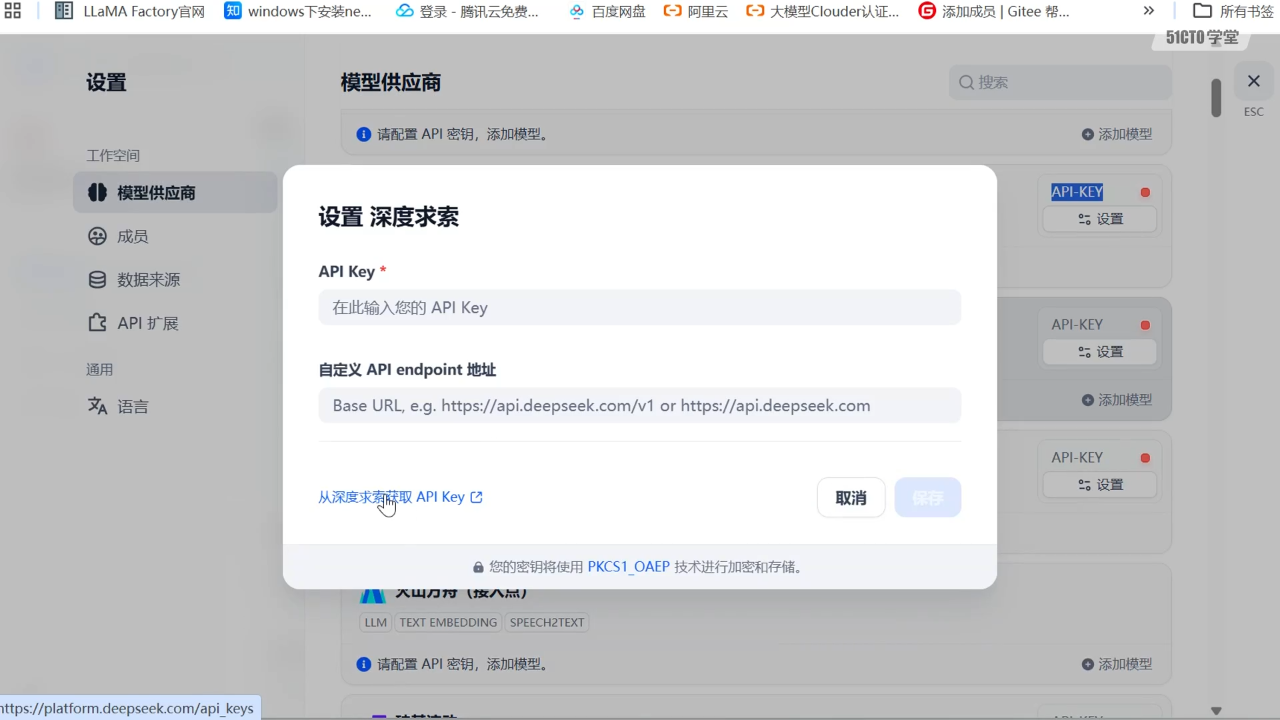
鉴权通常放在 HTTP 请求头里:
课程还演示了在 Dify、扣子(Coze)等平台里配置模型供应商、Base URL 和 API Key 的界面。这里的关键不是记住某个按钮的位置,而是分清三件事:
- API Key:证明“你是你”。
- Base URL:告诉程序“去哪个服务地址”。
- 模型名称:告诉服务端“具体调用哪个模型”。
五、最小 Python 调用
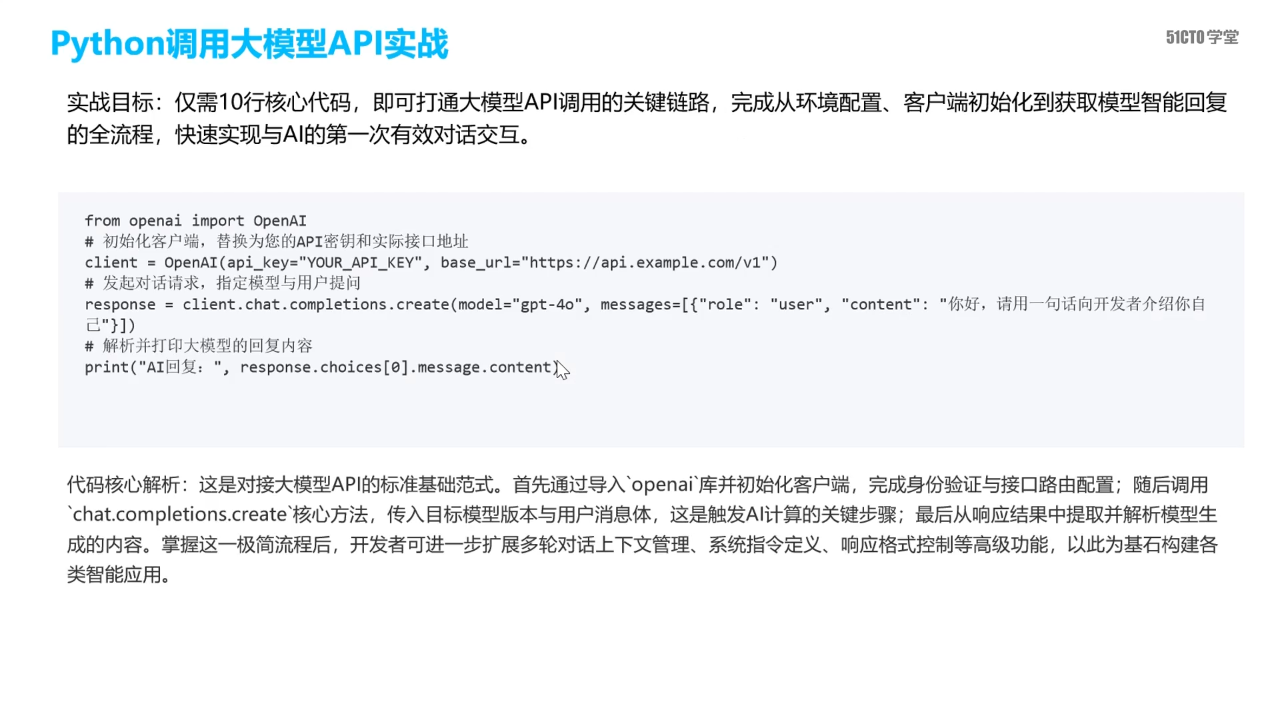
课程给出的最小链路可以抽象成四步:
四个动作分别对应:
- 导入 SDK。
- 用 Key 和 Base URL 初始化客户端。
- 指定模型与消息,发起
chat.completions.create。 - 从
choices[0].message.content取出回复。
六、常见坑
- 把 Key 写进代码仓库:应使用环境变量或密钥管理服务,不能把真实 Key 提交到 Git。
- 改错 Base URL:很多“401/404”不是 Key 错误,而是地址多了或少了
/v1。 - 把
max_tokens当成提示词长度:它限制的是输出,不是输入。 - 以为 temperature 越高越聪明:它只改变随机性;事实类任务通常要更低。
- 只取文本不看
usage:上线后很容易在成本和限流上踩坑。
七、自测题
- 为什么说“低代码平台也绕不开 LLM API”?
messages中system和user的角色分别是什么?temperature与max_tokens分别控制什么?- 从响应体的哪个字段取模型正文?哪个字段用于成本核算?
- 写出调用 LLM API 的四个最小步骤。
答案提示:1. 平台的底层仍要调用模型完成推理;2. system 定规则,user 给任务;3. 随机性与输出长度;4. choices[0].message.content、usage;5. 导入 SDK → 初始化客户端 → 发起请求 → 解析响应。
本节小结
这一节建立了智能体开发的最小闭环:用 Key 证明身份,用 Base URL 找到服务,用 model 选择能力,用 messages 传递上下文,用 temperature/max_tokens 控制输出,最后从 choices 和 usage 读取结果与成本。后面的 ReAct、RAG、工作流和工具调用,都是在这个闭环上继续加“工具、记忆和编排”。